灵感志
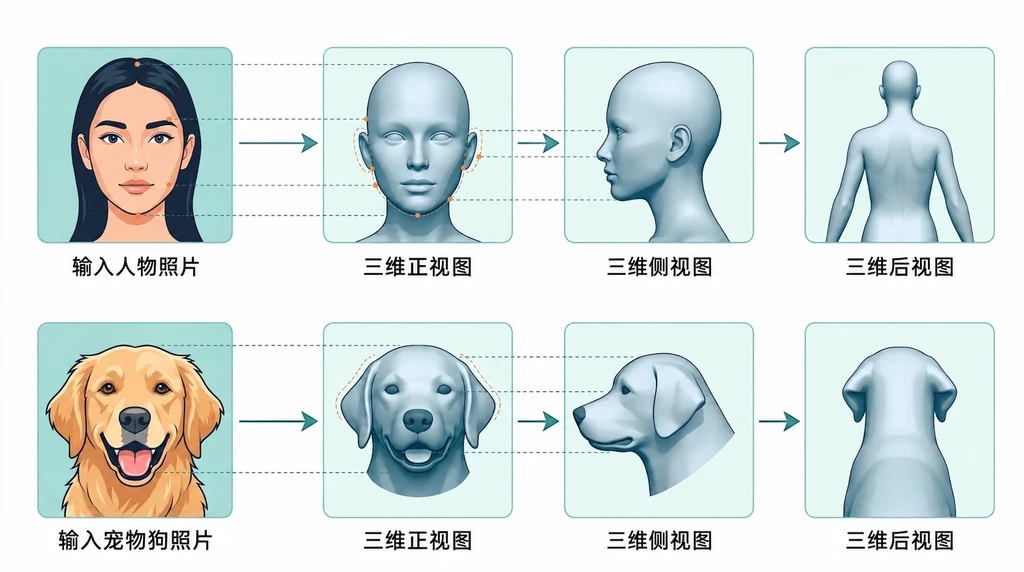
输入一张照片,生成一个可以在网页中旋转查看的人物或宠物模型,是图生 3D 的一个明确应用方向。对于这类任务,模型需要同时满足三个要求:输入视角下能够保留原主体的特征,转到其他角度时具有合理的结构,几何与纹理始终保持一致。
人物的脸型、发型和体态,宠物的耳形、口鼻比例和毛色花纹,往往决定了生成结果是否具有辨识度。围绕这些特征,可以将研究目标定义为“身份保真的三维生成”:在还原可见信息的同时,对不可见部分作出符合主体特征的合理补全。
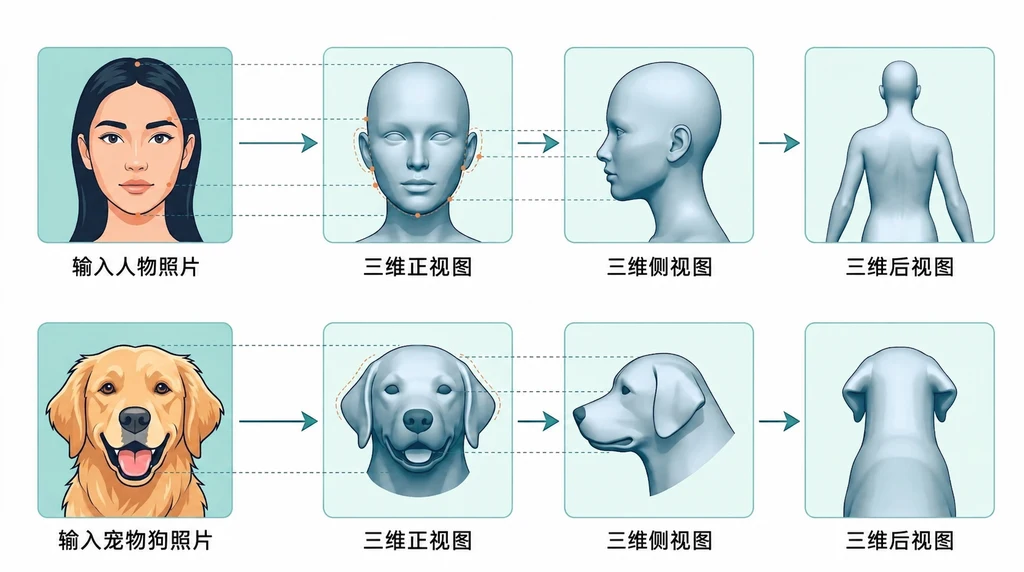
单张图像中的信息存在天然缺口。照片只记录一个视角下的投影,同一个像素可能对应三维空间中不同深度的表面。人物背面的衣服结构、宠物被遮挡的后腿和另一侧的花纹,都无法通过单张照片直接确定。因此,完整模型需要同时利用图像中的观测证据和训练数据中学习到的三维先验。
这也意味着,可见区域与不可见区域应承担不同的生成目标。前者强调还原,后者强调合理性。对于同一张照片,背面可能存在多个合理解释;算法能够约束这些解释与已知形状和外观协调,却无法保证恢复没有被拍摄到的真实细节。
现有图生 3D 研究,已经提供了可以相互配合的技术基础。
技术思路 | 代表方法 | 可以借鉴的能力 |
根据图像直接预测三维表示 | LRM、TripoSR | 将图像特征映射到三维表示,并通过轮廓与局部渲染监督改善细节 |
在三维潜空间中生成完整对象 | TRELLIS、TRELLIS.2 | 学习完整形状及外观的分布,为不可见区域提供生成先验 |
先生成其他视角,再恢复三维 | Zero123++、InstantMesh | 从单张图像推断多视角信息,并将其交给后续重建模块 |
显式建立像素与三维位置的对应 | Pixal3D | 让图像条件更准确地作用到对应空间位置,增强输入视角下的保真程度 |
这些思路描述的是不同层面的设计,可以组合使用。例如,像素对齐主要回答“图像信息怎样进入三维生成过程”,三维潜空间生成主要回答“怎样表示和生成完整对象”。它们之间并不存在必然的排斥关系。
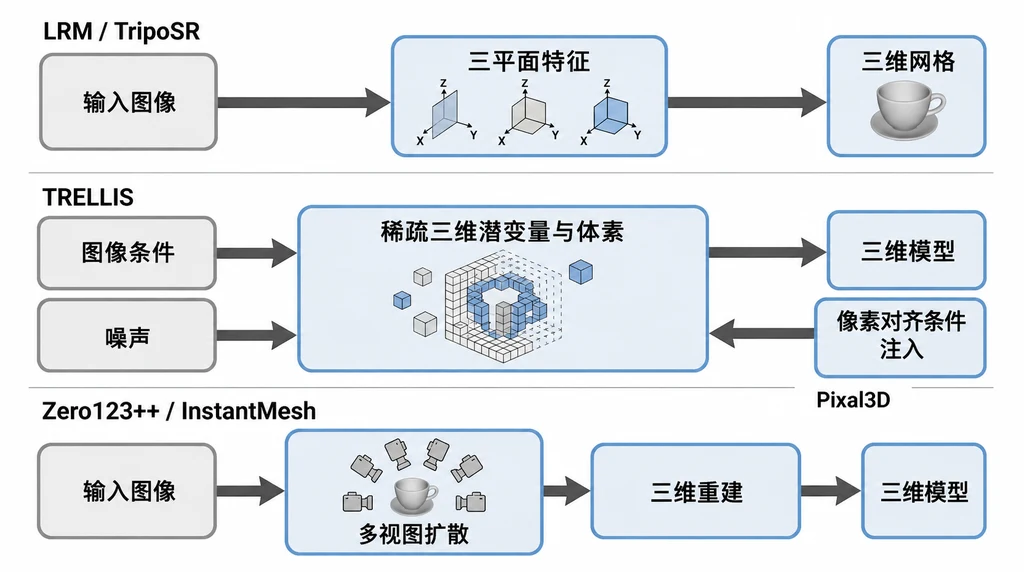
LRM 使用图像编码器与 Transformer,将输入映射为三平面特征,再通过空间查询预测密度和颜色。TripoSR 在这一基础上引入掩码损失及局部渲染监督。对人物和宠物而言,局部监督具有直接启发:全身照片中的脸、眼睛和耳朵通常只占较小区域,训练时需要给予这些部位足够关注。
TRELLIS 通过稀疏结构和局部潜变量表示三维对象,并采用流匹配生成;TRELLIS.2 进一步使用 O-Voxel 建模几何和材质。这类方法能够利用从完整三维资产中学习到的先验,补充单张图片无法直接提供的结构信息。
Zero123++ 提供了通过其他视角补充信息的方式:联合生成多个视角。InstantMesh 已将多视图扩散与基于 LRM 的重建结合。不过,生成视图本质上仍是模型推测。若不同视角对耳朵、肢体或花纹给出冲突解释,重建过程也可能把这些冲突固化到三维结果中。
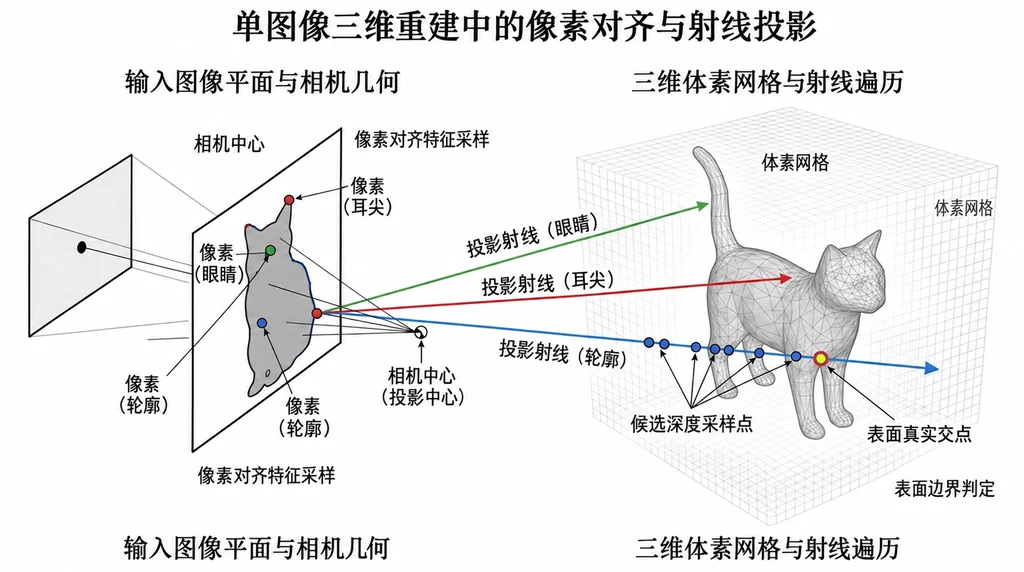
Pixal3D 通过显式投影关系增强输入保真。在相机坐标系中,将三维位置投影到图像,便可以从对应像素处采样特征:
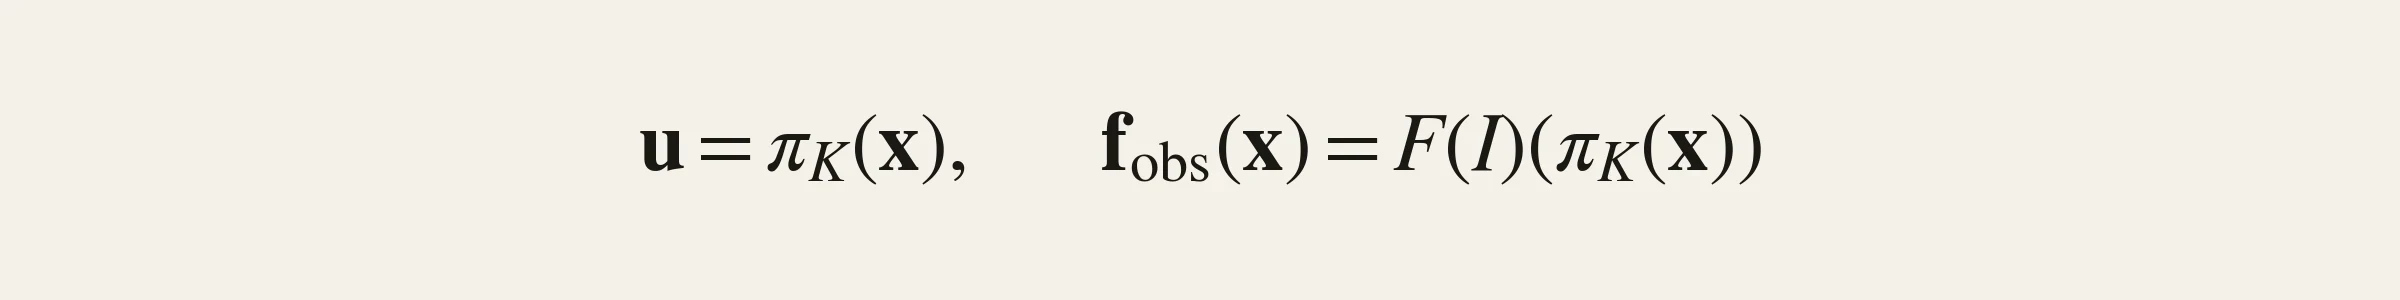
其中,(\mathbf{x}) 为三维位置,(\pi_K) 表示相机投影,(F(I)) 是图像特征图。这种映射让模型明确知道某个空间位置应从图像哪里获取信息。但一条射线上的多个位置仍可能获得相同图像特征,因此真实深度和表面位置依然需要模型推断。
上述能力已经出现在多家团队的公开工作中。腾讯混元与 Deemos 的 CLAY 探索了形状生成和多视图材质生成的结合;TripoSG 强调图像条件下的三维形状生成;Meta 的 SAM 3D Objects 注重真实照片中的遮挡和完整对象恢复;Meshy T2 则探索从粗结构到精细网格的生成。它们为技术融合提供了参照,但不能仅根据产品效果推断其内部采用完全相同的流程。
还需要区分论文版本与后续发布版:Pixal3D 原论文主要讨论几何生成,而其官方改进发布版已经基于 TRELLIS.2,并提供纹理生成和 GLB 导出。因此,面向人物和宠物的研究可以从已有完整生成能力出发,将改进集中到个体特征的保留和遮挡补全的可靠性上。
基于这些技术,可以提出一条待验证的融合流程:
全身与局部特征提取 → 初始三维结构生成 → 可见性与观测可靠性估计 → 几何及外观修正 → 多角度一致性验证。
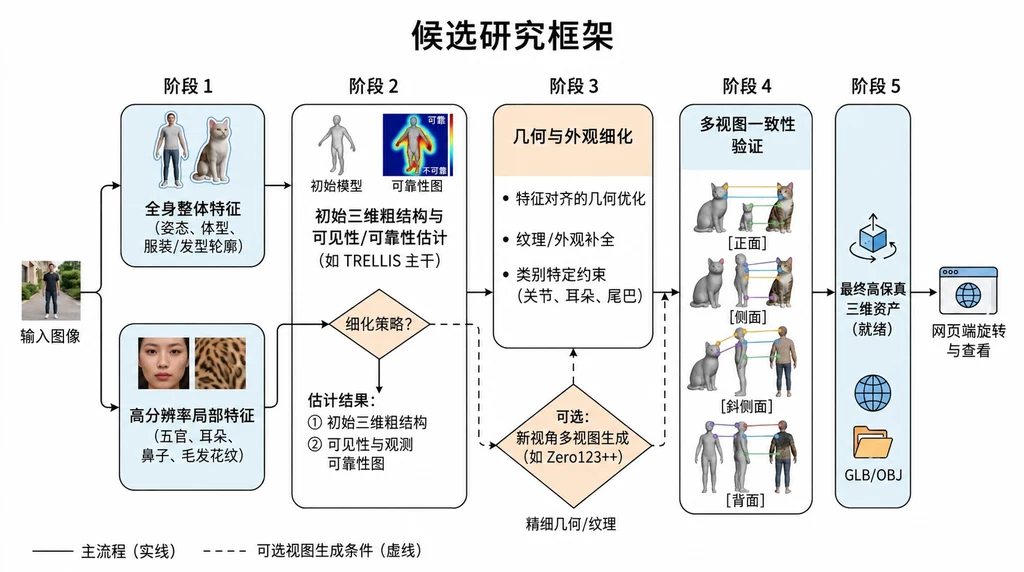
输入端同时保留整体与局部信息。全身特征描述姿态、体型和服装或毛发轮廓;高分辨率局部特征描述人物五官、宠物耳形、口鼻与花纹。局部裁剪应保留与原图的坐标关系,使这些特征能够映射到正确的三维位置,避免局部细节清晰但位置或比例失调。
通过已有骨干生成初始三维结构。初始模型提供完整形状假设,也可用于估计原图视角下的可见表面、深度和法线。这里的预测应保留不确定性:粗模型本身的错误可能导致错误的可见性判断,进而影响下一阶段的细化。
在初始几何基础上,引入待验证的“观测可靠性控制”机制。其目标是根据图像质量、边界状态和几何对应程度,调节局部图像信息对三维结果的影响。一种概念性的条件融合形式为:
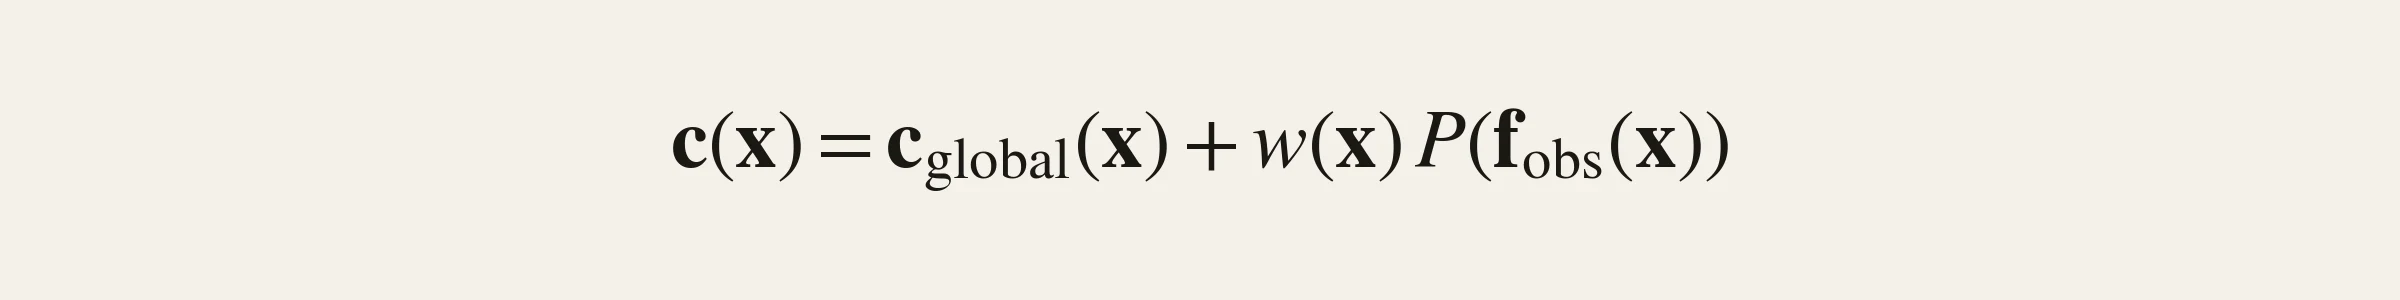
对于清晰可见、投影对应可信的五官和花纹,应强化图像约束;对于绒毛边缘、遮挡和模糊区域,则降低局部信息的强制影响,为生成先验保留补全空间。Pixal3D 原论文指出,分割边界噪声可能经反投影放大,因此这种机制对发丝、绒毛、耳尖和尾部边缘尤其值得研究。
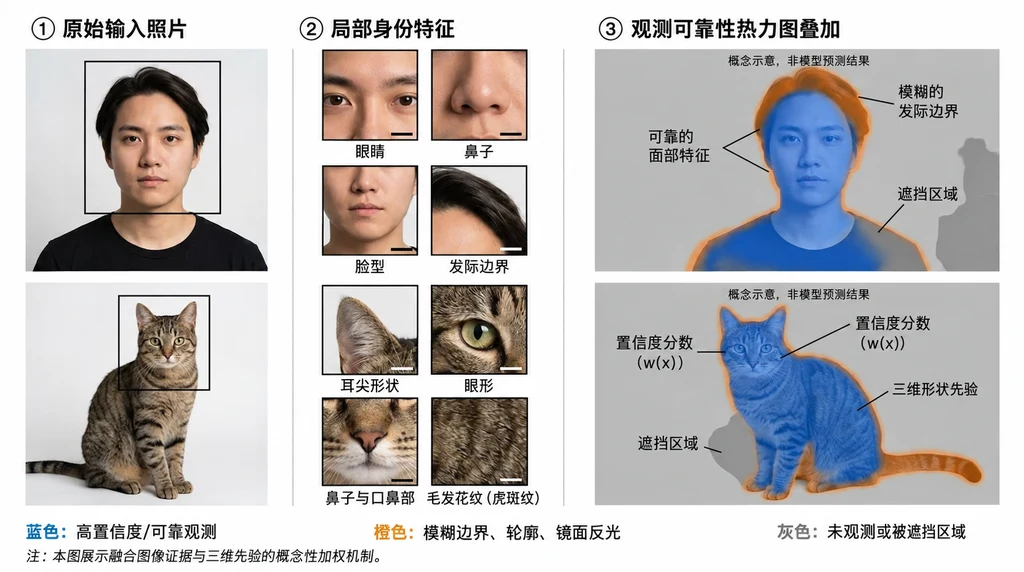
可靠性还必须能够接受监督。可利用已知三维资产的渲染结果建立可见性和对应关系,并对分割、相机和遮挡进行扰动,学习哪些信息值得信任。同时,需要约束模型始终响应可靠的原图证据,防止它把局部权重全部压低而只依赖先验。
对于不可见部分,可以直接利用三维先验补全,也可以引入受粗几何约束的新视图生成。后一种方式应明确区分真实照片与生成视图的来源,并降低不可靠生成信息对已确认特征的影响。例如,补全猫的侧面时,应保持原图可见的耳形和口鼻比例;补全人物背面时,应延续可见服装和发型的结构线索。
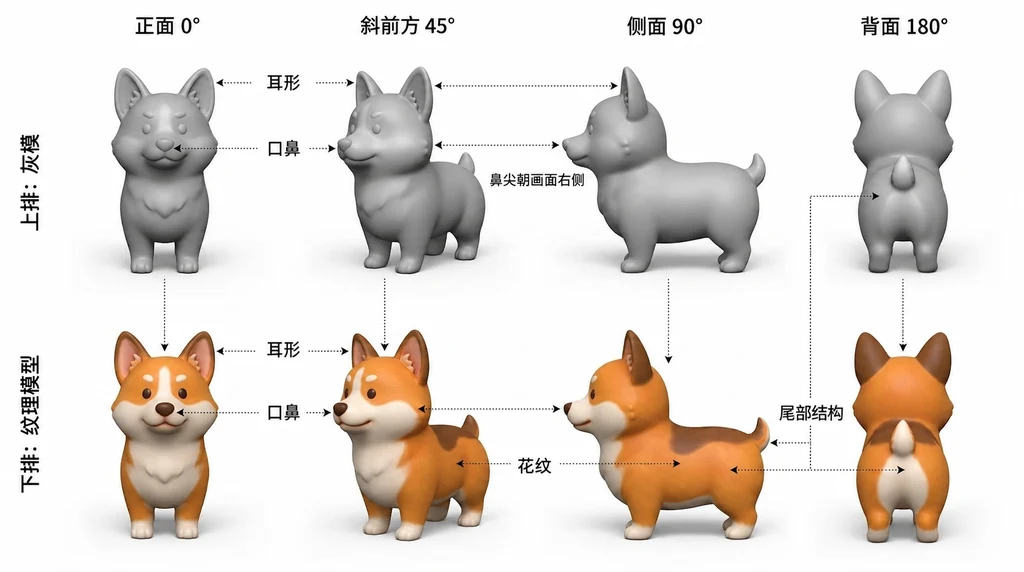
几何修正与外观生成需要相互约束。宠物脸部的色斑应位于正确的表面区域,人物的五官纹理应与实际形状一致。照片中的阴影和高光还需要与材质基础色区分,否则模型在网页中换一个角度或光照,就可能出现不自然的明暗关系。
人物与宠物可以共享部分图像编码和三维生成能力,但其结构先验需要有所区别。人体关节、服装与头发,和猫狗的四肢、耳朵、尾巴与毛发分布,具有不同的约束。类别条件或局部适配模块可以承担这些差异,而它们能否有效覆盖复杂姿态与遮挡,需要单独验证。
这条路线的研究价值,需要放在已有工作的基础上判断。Human-LRM 已经结合粗人体重建、新视角扩散与精细重建;SiTH 已探索生成背面后恢复完整人物;Unique3D 也使用了可见性等信息进行加权融合。因此,简单连接几个现有模型,或单独使用可见性和局部监督,并不足以证明算法创新。
可以进一步检验的研究问题是:针对人物和宠物,学习经过校准的局部观测可靠性,并让它共同控制几何与外观修正,是否能够减少复杂边界和遮挡造成的身份偏移?这一问题明确了改进位置,也提供了可验证的目标。
为区分目标领域数据和算法模块各自的作用,可设置以下对照:
实验组 | 主要变化 | 验证目的 |
原始基线 | 使用已有模型 | 确定初始生成能力 |
目标领域微调 | 加入人物与宠物数据 | 识别数据适配带来的收益 |
可靠性控制 | 在相同微调基础上加入可靠性模块 | 验证条件加权是否减少错误传播 |
局部身份监督 | 在相同微调基础上加强关键部位监督 | 验证局部细节能否更好保留 |
联合方案 | 同时采用上述两个模块 | 检查联合收益及相互影响 |
对比时应控制训练数据、推理设置及评价条件。人物与宠物应按主体划分训练和测试数据,避免相同主体或三维资产的不同视角跨集合出现。
评价应覆盖三个方面:
· 可见特征保真: 原图视角下的轮廓、脸型、耳形和纹理对应程度。
· 三维结构合理性: 侧背面的形状、肢体关系及明显生成错误。
· 跨视角外观一致性: 旋转过程中花纹、材质和几何位置的稳定对应。
网页预览最终提供了直观的检验方式:转动模型时,脸型是否连续,耳朵是否变形,花纹是否位于正确位置,肢体是否保持合理结构。围绕这些问题建立生成与评价流程,可以把“身份保真”落实到具体可观察的结果,并逐步判断哪些技术组合值得继续发展。